一文读懂 Memory Compiler 参数配置背后的物理意义
2026-09-10
—— 从 Mux、Bank 到 Vt,深度拆解 SRAM 的 PPA 权衡本质
IPSoar技术科普
摘要:在 SoC 芯片设计中,SRAM 的 PPA 表现深刻影响芯片项目竞争力。Memory Compiler(MC)具备大量可调参数,支持对 SRAM 实例开展精细化调参。只知晓参数如何调整远远不够,理解参数背后的物理原理,是帮助设计人员做出合理 PPA 权衡的重要依据。本文延续过往 MC IP 技术科普内容,从物理本质剖析 Mux、Bank、Vt 关键参数对 SRAM 面积、性能、功耗的影响逻辑,助力工程师做好存储器 IP 选型,减少后端迭代
一、Column-Mux:重塑存储阵列形态,实现面积-速度-功耗的基础权衡
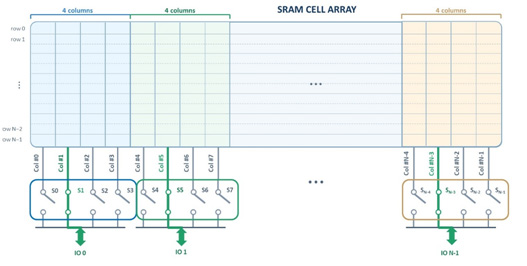
Memory Compiler 中的 Mux,通常特指 Column-Mux(列复用)。在 SRAM 的 Word(字数)与 Bit(位宽)固定的前提条件下,Mux 配置直接决定了存储阵列(Array)的物理版图是「高瘦」还是「矮胖」,而这正是它影响 PPA 的根本原因。
以下为column mux在memory中的示意图:
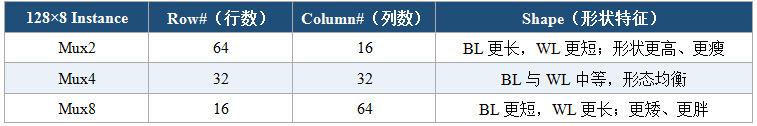
为了更直观地理解这一过程,我们以一个 Word=128、Bit=8 的 Memory Instance 为例。当 Mux 分别取 2、4、8 时,存储阵列的物理形状、行数与列数均会发生显著变化,如下表所示:
表 1 128×8 Instance 在不同 Mux 下的阵列形态对比
下图即为阵列物理结构示意图:
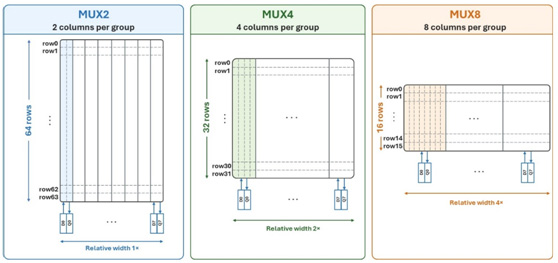
上述变化的本质可以由以下公式精确定义——在 Word 与 Bit 给定的情况下,Row 与 Column 的数量完全由 Mux 决定:
Row = Words / Mux
Column = Bits × Mux
由此可见,Mux 增大的直接效果是:行数减少、列数增加。反映在物理版图上,即位线(Bit Line,BL)变短、字线(Word Line,WL)变长,整个阵列从「高瘦」走向「矮胖」。正是这种形状的改变,引发了面积、速度和功耗的一系列连锁反应。
物理机制深入分析
• 位线(BL)负载效应:位线是一条贯穿整列的金属走线,其上并联着大量存储单元。BL 越长,寄生电容越大,充放电时间越长,直接拖慢读写速度并增加动态功耗。因此,缩短 BL 是提升性能的重要手段。
• 字线(WL)负载效应:字线沿行方向延伸,WL 越长,其电阻-电容(RC)延迟越大,选中一整行所需的时间也随之增加。因此,过长的 WL 同样会成为速度的瓶颈。
• 折中本质:Mux 的调整,本质上就是在「长 BL + 短 WL」与「短 BL + 长 WL」之间做权衡。由于不同 Instance 的 Word 与 Bit 比例各异,不存在普适的「最优 Mux」,必须结合实际规格具体分析。
实例数据:以 IPSoar 22nm MC 为例
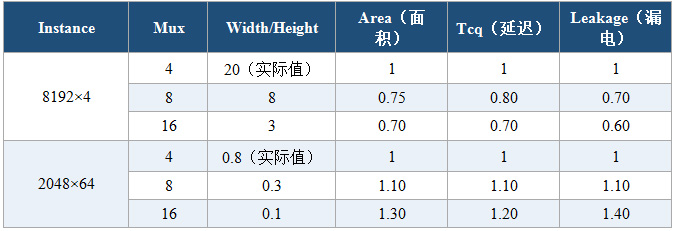
为了量化 Mux 对 PPA 的影响,我们选取 IPSoar 22nm 工艺节点的 Memory Compiler,针对两种典型 Instance 规格(8192×4 与 2048×64),对比 Mux 取 4、8、16 时的面积(Area)、时钟到输出延迟(Tcq)与漏电功耗(Leakage)。为便于比较,各项指标均以 Mux=4 为基准归一化(值=1):
表 2 IPSoar 22nm MC 不同 Mux 下的 PPA 对比(归一化数据)
数据分析:
• 规律 a —— 形状与面积的关联:不同 Mux 值下,SRAM 的形状截然不同,面积也随之变化。对于 Word 偏大(8192)、Bit 偏小(4)的 Instance,增大 Mux 能显著缩短过长的 BL,使阵列更紧凑,面积从 1 降至 0.7,收益明显。
• 规律 b —— 速度与时序的关联:同样以 8192×4 为例,Mux 从 4 增至 16,Tcq 由 1 改善至 0.7,速度提升约 30%。这正是因为过长的 BL 被大幅缩短,消除了主要的延迟瓶颈。反之,对于 Word 偏小、Bit 偏大的 Instance(如 2048×64),增大 Mux 反而使本已很长的 WL 进一步拉长,导致速度和面积同步恶化。
• 核心结论:不同mux会表现不同的形状和PPA,是MC选择instance的基石参数。
二、Bank:切割存储阵列,以更大面积开销换取更高读写性能
面对先进工艺下愈发多元的设计诉求,仅依靠 Mux 调整,往往难以完全覆盖速度与面积之间的折中需求。此时,Bank 分块成为另一项重要的调参手段。
Bank 的物理原理
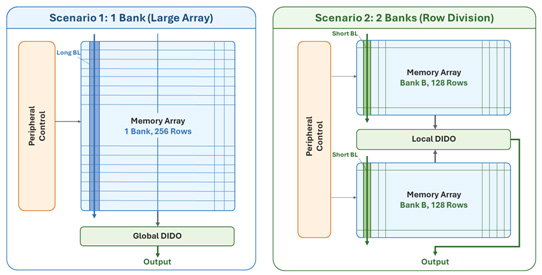
Bank 的本质,是将整个存储阵列沿列方向切分为多个相互独立的子存储块(Sub-bank)。每一个 Bank 都拥有自己独立的外围电路,包括灵敏放大器(Sense Amplifier)、列译码器(Column Decoder)以及本地控制信号等。增加 Bank 数量,意味着将一条贯穿全阵列的长位线「打断」成多条更短的子位线,从而显著降低单条 BL 上的负载电容。
具体而言,Bank 选择不同,阵列在 Column 方向的切分方式也随之不同。例如,对于一个总 Row 数为 256 的 Instance:当选择 Bank=1 时,所有 256 行归属于同一个 Bank;当选择 Bank=2 时,阵列被对半切分,每个 Bank 承载 128 行;当选择 Bank=4 时,每个 Bank 仅承载 64 行。Bank 越多,单个 Bank 的行数越少,对应的 WL 与 BL 越短,读写速度也就越快。
下图为Bank 1和Bank 2的物理结构示意图:
「以面积换速度」的权衡逻辑
• 性能提升机制:Bank 分块后,每条位线的长度按比例缩短,寄生电容随之下降,灵敏放大器需要驱动的负载大幅减小,信号传输延迟显著减小,从而有效提升读写速度。这是典型的「以空间换时间」策略。
• 面积代价:每个 Bank 都需要配备一套完整的外围电路。Bank 数量越多,重复的外围电路占比越高,芯片总面积随之增大。同时,Bank 之间还需要额外的隔离与布线空间。
• 功耗变化:由于面积增大、晶体管数量增多,静态漏电功耗(Leakage)通常随 Bank 数量增加而上升。但在高频工作场景下,由于位线电容减小带来的动态功耗下降,可能部分抵消甚至超越漏电的增加,需结合具体工作频率评估。
• 适用场景:当芯片对读写速度有严苛要求(如高性能计算、AI 加速器等),而对面积与功耗相对宽容时,增加 Bank 是行之有效的架构方案。
实例数据:以 IPSoar 22nm MC 为例
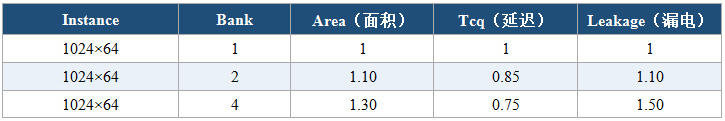
以下同样基于 IPSoar 22nm MC,针对 1024×64 规格的 Instance,对比 Bank 取 1、2、4 时的 PPA 归一化数据:
表 3 IPSoar 22nm MC 不同 Bank 下的 PPA 对比(归一化数据)
数据分析:
• Bank 从 1 增至 4,面积增加约 30%(1 → 1.3),Tcq 则改善约 25%(1 → 0.75),速度提升显著,印证了「面积换速度」的预期。
• 同时,Leakage 从 1 上升至 1.5,增幅甚至超过面积增幅,说明外围电路的漏电贡献不可忽视。
• 重要提示:由于面积增大引入了额外的走线与电路延迟,部分 Instance 在 Bank 数过多时,反而可能因互连开销增大而导致整体时序恶化。因此,Bank 的选择并非越多越好,最终仍须以 MC 实际产生的数据为准,结合具体设计目标综合决策。
三、Vt:调控外围电路阈值电压,灵活平衡速度与漏电功耗
与前两者从「阵列结构」入手不同,Vt(阈值电压)选项是从「晶体管级」出发,通过修改 SRAM 外围电路(Periphery)中晶体管的阈值电压,为客户在 Speed 与 Power 之间提供更加灵活的选择空间。
Vt 的物理内涵
晶体管的阈值电压(Vt)是决定其开关特性的核心参数,直接影响电路的两大关键指标:
• 速度:Vt 越低,晶体管导通电流越大,门延迟越小,电路开关速度越快。
• 漏电:Vt 越低,亚阈值漏电(Subthreshold Leakage)呈指数级增长,静态功耗急剧上升。
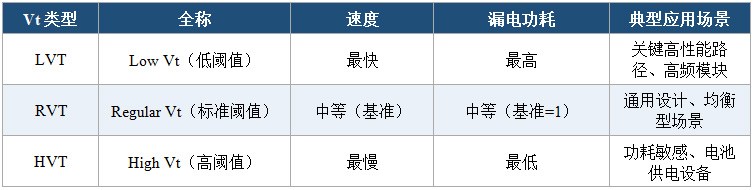
因此,Vt 的选择本质上是在「性能天花板」与「功耗预算」之间的一次精准博弈。Memory Compiler 通常提供三种典型的 Vt 选项,供设计师根据应用场景灵活取舍:
表 4 三种 Vt 选项的特性对比
实例数据:以 IPSoar 22nm 为例
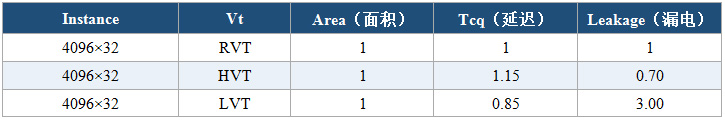
以下基于 IPSoar 22nm 工艺,针对 4096×32 规格的 Instance,对比 RVT、HVT、LVT 三种 Vt 下的归一化 PPA 数据:
表 5 IPSoar 22nm 不同 Vt 下的 Speed 与 Power 对比(归一化数据)
数据分析:
• 面积不变:Vt 仅改变晶体管的掺杂与阈值,不改变版图尺寸,因此三种 Vt 下面积保持一致(均为 1)。
• 速度-功耗的跷跷板:LVT 将 Tcq 缩短至 0.85(提速约 15%),但漏电飙升至 3 倍;HVT 将漏电压缩至 0.7(节省 30%),但速度牺牲约 15%。这正是 Vt 调节的核心价值——在不改动阵列结构的前提下,通过器件级优化为设计提供额外的自由度。
• 应用建议:在实际 SoC 设计中,可对性能关键路径上的 SRAM 选用 LVT,对时序宽裕、功耗敏感的模块选用 HVT,通过混合配置实现全局 PPA 最优。
四、总结:三大参数的协同优化策略
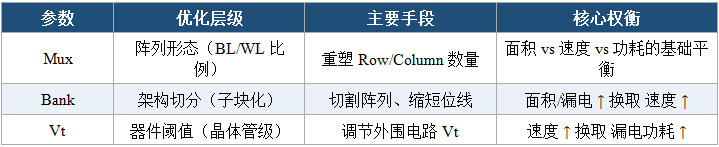
Mux、Bank、Vt 分别从阵列形态、架构切分与器件阈值三个不同层级,为 SRAM 的 PPA 优化提供了丰富的调参维度。三者既可独立配置,也可协同组合,形成层次化的优化策略:
表 6 三大参数优化维度一览
协同优化建议:
• 第一步 —— Mux 定基调:根据 Instance 的 Word/Bit 比例,选择合适的 Mux,确定阵列的基础形状与 BL/WL 比例,完成面积的初步优化。
• 第二步 —— Bank 冲性能:若速度仍未达标,通过增加 Bank 数量切割阵列,以可控的面积开销换取显著的时序改善。需要强调的是,有些memory instance由于bank变大后,逻辑电路复杂化和面积增加导致的全局负载增加,速度不一定变快。
• 第三步 —— Vt 精调节:在结构确定后,通过 Vt 选项在外围电路层面做最后的 Speed/Power 微调,实现局部最优。
• 最终验证:所有参数组合均以 MC 实际输出的 PPA 数据为准,结合项目的具体约束(面积预算、时序签核、功耗上限)进行综合取舍。
结语:深入理解 Memory Compiler 参数背后的物理意义,是每一位芯片设计工程师从「会用工具」走向「用好工具」的必经之路。希望本文的拆解能够帮助您在存储器 IP 选型时更加从容自信,从项目早期就锁定最优 PPA 方案,有效避免后端反复迭代的风险。IPSoar 将持续输出更多高质量的硬核技术内容,与行业同仁共同推动存储器 IP 技术的创新与发展。
IPSoar Memory compiler专属快捷优化建议:
• 为解决 SRAM 选型难题,IPSoar 推出了 MindExplore 工具。用户仅需设定 Word 和 Bit及使用频率,工具便能枚举所有合规 Instance,并支持按 面积和功耗 指标排序,帮助客户告别繁琐的手动比对,一步到位筛选出最适配的方案
• 该工具既可以支持GUI方式,也可以支持batch command方式,方便客户更高效的选择SRAM instance。
腾芯微电子COO周斌表示:“Memory Compiler IP 是 SoC 芯片里的核心基础模块,IP 厂商不仅仅是向客户交付 IP Design Kit,更要输出配套的技术理解与工程经验。国内芯片设计行业快速发展,不同团队工艺积累参差不齐,我们坚持做系列化技术科普,就是希望把我们在 Memory Compiler 上沉淀的设计理解、调参经验开放出来,帮助国内设计团队少踩坑、提升项目成功率。未来腾芯微会持续打磨国产 Foundation IP 产品,同时持续输出高质量技术内容,与国内芯片生态协同成长,助力本土芯片产业高质量发展。
【关于腾芯微】
苏州腾芯微电子有限公司(2018年成立,总部位于苏州市)是国内领先的一站式Foundation IP及Memory IP供应商,专注于提供高可靠性、高PPA竞争力的IP解决方案。产品线完整覆盖Memory Compiler、Standard Cell Library、GPIO、TCAM Compiler及OTP等核心IP,工艺节点支持0.18μm至28nm及先进工艺平台。
作为国内 16 家主流 Foundry 官方认证的合作伙伴,公司不仅跻身少数能为成熟工艺至先进制程提供全链条 IP 支持的厂商行列,还凭借稳定的交付能力与高品质的Foundation IP产品与服务,荣获多家 Foundry 颁发的优秀供应商荣誉。IP产品在40nm/28nm及先进节点中,PPA(功耗/性能/面积)指标较行业平均提升5%-20%。公司专注于Foundation IP的可靠性,依托完善的品质检验流程,现已通过ISO 9001质量体系、ISO 27001信息安全认证与ISO 26262功能安全管理体系ASIL D认证,确保流片成功率100%。
腾芯微电子始终以“高品质基础IP赋能客户”为使命,通过持续的技术迭代与客户协同,助力合作伙伴实现从IP选型、芯片设计创新到量产成功的全周期价值提升。
公司邮箱:sales@ipsoar-tech.com
更多详情,请访问:www.ipsoar-tech.com